📈 本周趋势
本周最强的技术线是 harness 之辩。OpenAI Codex 的 Tibo 判断 harness 会随模型进步越来越轻,临时拐杖随模型追上就删;Anthropic 的 Thariq 结论相反,模型越强 harness 越复杂,沙箱与自动模式正在成为承重结构。UC Berkeley 的 HarnessTax 交出第一份量化裁判:21 组模型×harness 实测,成功率几乎不受 harness 影响、成本最多差 5 倍,极简的 Pi 与官方 harness 同档。教模型做事的部分在变轻,让模型安全做更多事的部分在变重。
另一条线是把 agent 工程变成可度量的系统。Anthropic 交出 CI 账本:人均代码量 8 倍、Claude 写 80%、CI 任务量六个月涨 25 倍;美团发布 Agent 评测白皮书,四模块三能力两条 Loop 一套资产;腾讯技术工程梳理 Context Engineering 范式,判断大多数 Agent 失败不再是模型失败,而是上下文失败。产出、评测、上下文,agent 工程的三个基本面本周都有人交了作业。
🚀 产品与模型动态
🟠 Claude Code
本周从 2.1.268 推进到 2.1.274,连发七版:
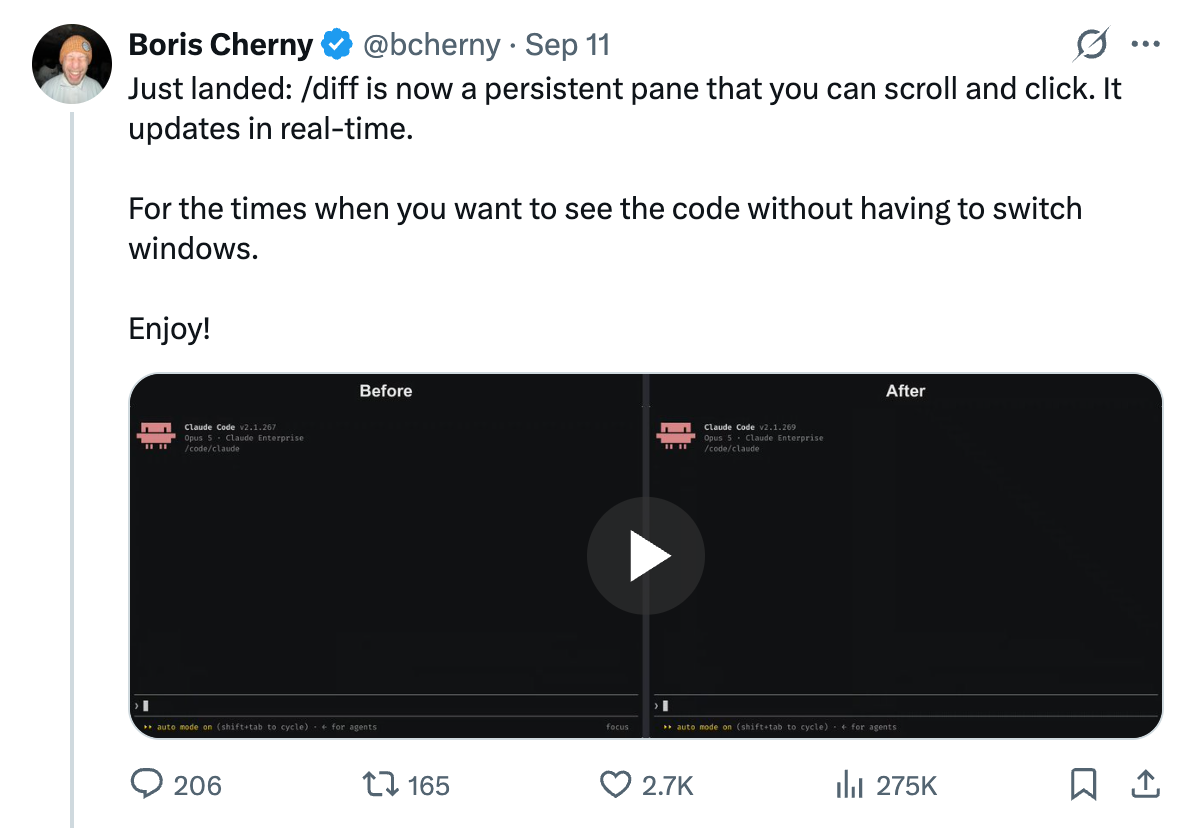
/diff持久面板(2.1.268):Boris Cherny 在 X 官宣,/diff现在是可滚动、可点击的常驻面板,随 Claude 的编辑实时更新,不用再切窗口看代码。配合同版本的/focus提示,终端里的「看代码」体验向 IDE 靠拢。
/code-review瘦身:对所有无独立调参的模型改用更精简的 inline review prompt,不再为一次评审 spawn 大量 review subagent。评审的 token 账单直接受影响。- auto mode 按命令放行域名:沙盒模式下 Bash、PowerShell、Monitor 每条命令的所需域名随命令一起审查、仅对该命令放行,其余域名一律拒绝。网络面收紧到命令粒度。
- transcript 自愈:会话卡在 “unexpected tool_use_id” 400 错误死循环的问题修复,损坏的会话记录能自愈,不能自愈的会给出明确报错和
/rewind提示。 claude plugin eval:对一个插件跑评测套件,产出可复现的打分报告(JSON 加 HTML),插件质量第一次有了命令行级的验收工具。- VS Code 侧:新增 agent map(按 N agents 徽标打开子 agent 地图,可看只读 transcript 和逐 agent 状态)、Hooks 管理对话框、Permission rules 管理对话框。
补遗(#15 期漏报):/design 画板能力已进 Claude Code。在终端里直接创建、编辑和同步设计项目:导入设计系统后 Claude 基于既有组件构建、把代码变成可交互原型;Claude Design 侧的 /design-sync 反向把设计系统拉进 Claude Code,设计稿交接不再靠截图。官方文档 Week 34有载,此前周报从未覆盖。
- Design 并入 Claude 本体(官方公告):Cowork 与 chat 合并为一个 Claude,Claude Design 进入任意对话,同一会话可直接产出 design review deck 和 UI mockup,Claude Code 场景也能调用;Claude Docs 与 Claude Slides 同日发布(公告)。
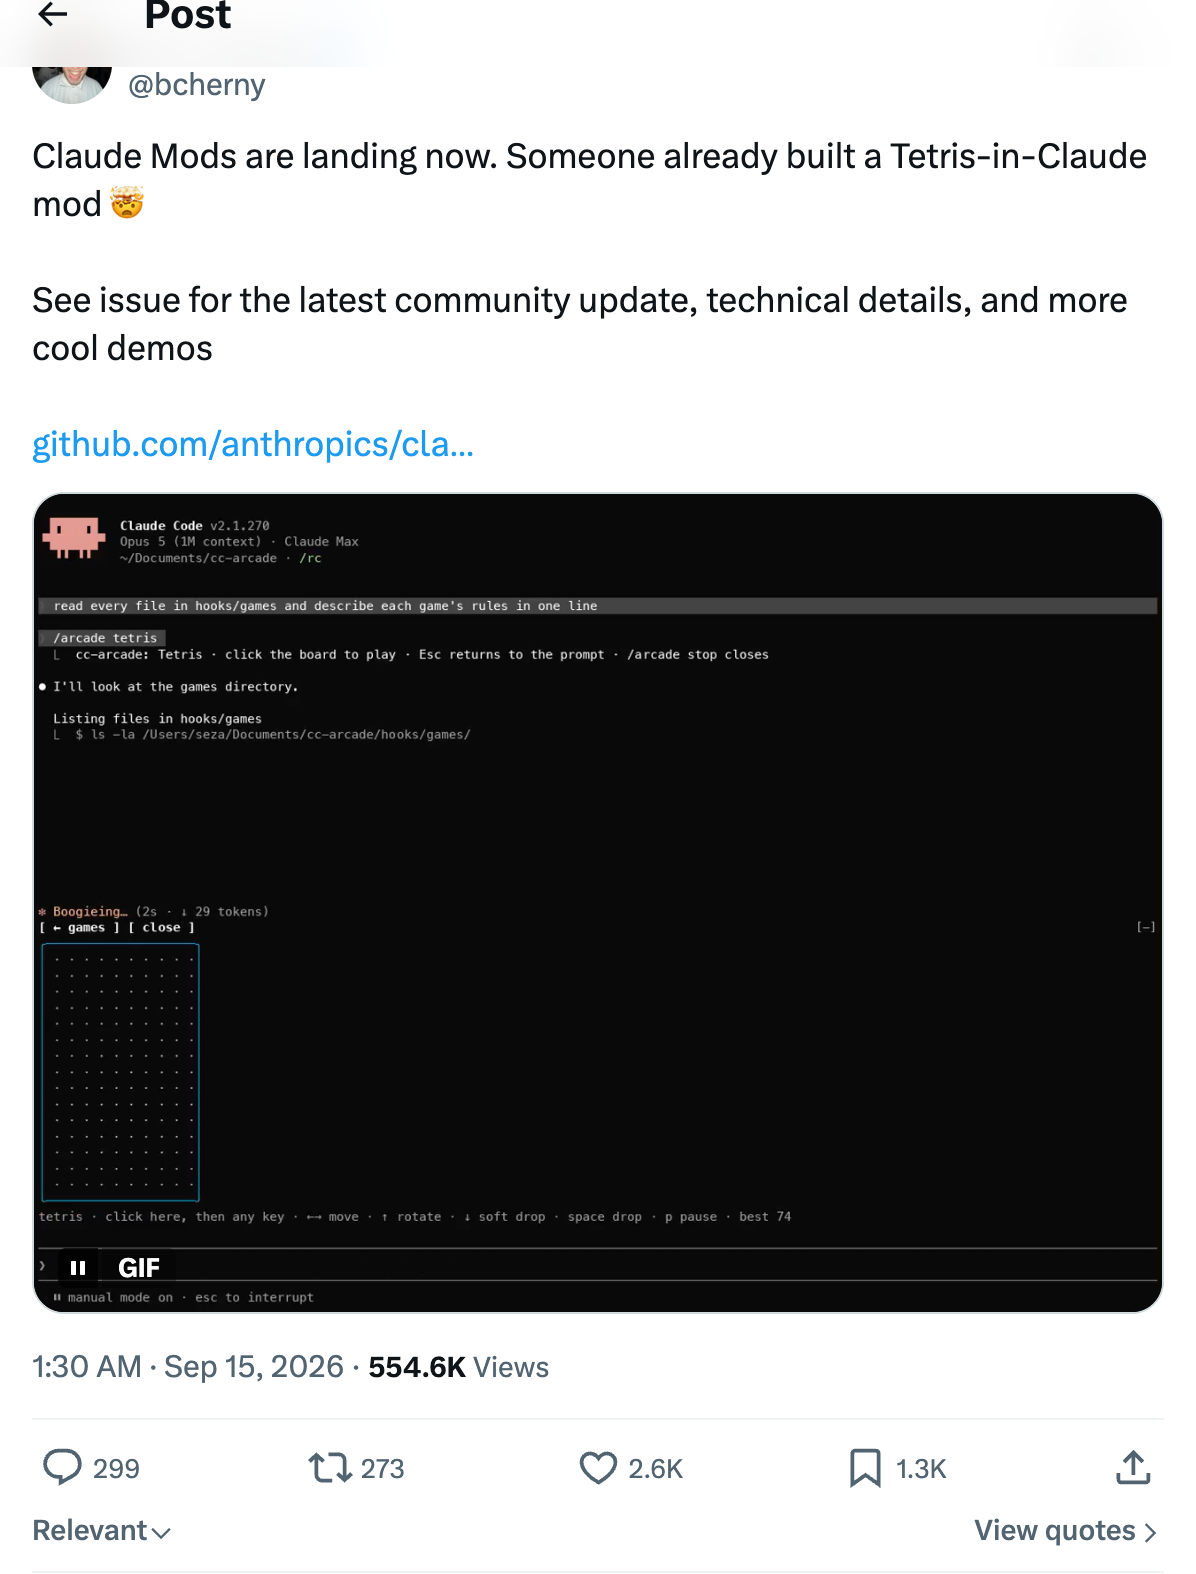
社群信号(Boris Cherny 推文):Claude Mods 开始落地。社区开发者已经用函数 hooks 加 ui.render 做出了跑在输入框上方的 Tetris 等 8 个游戏,Claude 干活时你可以打游戏,全程零 token 消耗。技术细节见 claude-code issue #91870:AbovePrompt 渲染面、turn.complete 事件暂停游戏、tool.call 事件给宠物喂食、$.store 存分数,API 已经能用,文档还没跟上。
🟢 Codex
本周没有新的 stable 版本(stable 停在 0.153.4),0.155.0 的 alpha 连发十个,处于密集迭代期,changelog 均为自动发布无用户可见说明,等 stable 落地再看。
社群信号(Tibo Sottiaux 推文):ChatGPT 里服务了 10 亿用户的语音系统开放构建,全双工对话加可靠的 tool calling 都能拿来搭自己的应用,原推 里 Tibo 的判断是用过全双工之后就回不去纯文本交互了。
🧰 其他工具与模型
- DeepSeek v4-pro 已于 9 月 14 日中午起全部路由到 v4.1 Flash:官方公告确认,切换已在本周生效,调用
deepseek-v4-pro的请求按 v4.1 Flash 单价计费。还在用旧端点的工程团队记得核对账单和模型行为。 - SWE-2 上线 Devin Desktop 与 Devin CLI:Cognition 的自研模型首先服务自家产品,API 开放时间未公布。
- GPT-6 Astra 官方 prompting 指南发布:OpenAI 开发者博客发文教用户重新审视 skills 和 AGENTS.md,详见本周精选。
📌 本周精选
Codex 想让 Harness 消失,Claude Code 却要把它做成承重墙
模型越强,教模型做事的 harness 在变轻,让模型安全做更多事的 harness 在变重,两个方向同时发生。
OpenAI Codex 团队的 Tibo 判断 harness 会随模型进步越来越轻:harness 比模型领先一点,用额外指令当拐杖,模型追上来拐杖就删,一部分 harness 逻辑从一开始就是临时的,甚至宁可等下一版模型也不打补丁。Anthropic Claude Code 的 Thariq 结论相反:模型越强 harness 反而越复杂,Claude 能连续跑数小时之后,沙箱、分类器、自动模式、工作流正在从辅助组件变成承重结构。InfoQ 的综合判断是两种说法并不矛盾:轻的是「教模型怎么做事」的部分,重的是「让模型安全、长期、并行做事」的部分。Thariq 对话里的干货密度很高:Claude Code 系统提示词已删掉约 80%,过去写在工具描述里的示例现在反而起负作用;测试代码应该比过去多约 100 倍,验证能力才是可维护性;大 PR 要附 Artifact 列出全部 prompt 包括失败的尝试;技术债按 1 到 2 个月的价值尺度决定是否等下一代模型。
别再只卷 Prompt 了,真正拉开 Agent 差距的是 Context Engineering
大多数 Agent 的失败已经不再是模型的失败,而是上下文的失败;Harness Engineering 就是上下文工程在 coding 场景的落地体系。
腾讯技术工程的三万六千字长文,把 Prompt Engineering、ReAct、Context Engineering 三代范式串成演进线之后,用一整章完成 CE 与 Harness 的映射:Rules(CLAUDE.md 类规则文件)把指令从对话里临时写变成版本化资产,Skills 封装验证过的方法,Memory 和 Cases 沉淀过往经验,CE 回答「为什么管理、管理什么」,Harness 回答「怎么沉淀成团队资产持续积累」。给 Claude Code 做的机制对照表值得收藏:CLAUDE.md 借首因效应注入核心规则、glob/grep 即时检索不预载全库、TODO.md 做结构化外部笔记、compaction 保留摘要加最近文件。反模式清单同样实用:工具调用结果消化后不清除、拿大窗口当解决方案(信号稀释在任何大小的窗口都存在)、系统提示枚举场景而不是给原则。文末的「什么场景需要完整 CE 体系」判断表可以直接对照自查。
Anthropic 披露 agentic coding 正在压垮 CI:人均代码量 8 倍、CI 任务 6 个月涨 25 倍
agent 提速之后先崩的是 CI;按两个季度内 25 倍负载设计架构,「过度工程」的门槛正在消失。
这是「agent 写完代码之后瓶颈去哪了」的第一手量化复盘。Anthropic 工程师人均季度代码量达到 2021-2025 均值的 8 倍,其中 Claude 写了 80%;测试数量涨 10 倍而工程师只多了一点;CI 任务量 6 个月涨 25 倍,直接原因是 Claude 偏好更小更细的 PR,且 agent 夜间周末持续推送。他们的确定性 test selection 服务(listener 记录结果、selector 决定每个 PR 跑哪些测试)被迫走了三次补丁:换大机器撑了 70 天,按 package 分 shard 撑了 29 天,每日重启撑不到 1 天,最终推倒重写为 journal 加无状态 worker 加 in-memory store 架构,单工程师 3 周完成,一年前这需要一整个季度。三条建议对每个正在上 agent 的团队直接适用:v0 就按两个季度内 25 倍负载设计;给服务装上 instrumentation 当 Claude 的眼睛耳朵,让它自己爬坡修问题;从第一天起把状态移出进程。最有意思的细节:作者用内部版 Claude Tag 开了数月长会话监控这个服务,Claude 一直主张推倒重写,人类一直选择再打补丁,最后模型是对的。
美团发布 Agent 评测白皮书:四模块、三能力、两条 Loop、一套资产
搭 Agent 的门槛在快速降低,把 Agent 做好的认知仍然稀缺,中间的差距就是评测。
美团评测团队把两年多业务实践整理成体系白皮书(系列共四篇,这是第一篇)。核心框架可以背下来:四个模块(离线评测守住已知、在线评测与监控发现未知、Case 挖掘与归因定位问题、观测基建是地基)、三种能力(发现、定位、驱动演进)、两条 Loop(Agent 迭代与评测体系迭代,在 Case 挖掘处咬合)、一套资产(端到端加过程评测集)。落到可操作:评测集分端到端与过程两类,前者回答「事有没有办成」,后者回答「中间哪一步出了问题」;回测用 Pass@k 取稳定结论、Rubric 分层门禁并接进 CI 才有约束力,没有接入流程的门禁只是一个建议;最容易被低估的是黄金集,「Bad Case 告诉你哪里不行,但不能告诉你到什么程度才算行」。文末的成熟度自查表可以直接对照打分找短板。
UiPath 实测 Claude Code skills 触发率:基线 micro-recall 只有 46%,一行描述修复法拉到 67%
超过一半「本应触发 skill」的 prompt 什么都没触发,不是触发错,是压根没触发。
Progressive disclosure 意味着 agent 只凭一行 description 决定是否拿起某个 skill。UiPath 给自家 20 个 Claude Code skills 做了触发率测量,结果刺眼:micro-recall 基线 46.3%。他们先踩的坑很典型:detector 只识别 Claude 的 Skill tool 调用,而 Codex 和 Antigravity 是直接打开 SKILL.md 文件,跨 agent 的第一个数字测的其实是你的 checker 而不是模型。最有效的修复是一行式描述「Always invoke for X」,X 必须是该 skill 独有的锚点(文件扩展名、独有产物文件名):整体 recall 从 46.3% 拉到 67.3%,precision 保持 0.96,最隐蔽的 diagnostics skill 从 0.16 拉到 0.68。边界也清楚:横切的 review skill 不拥有任何独特标记,靠描述工程救不了。eval harness 已开源(Apache 2.0),写 skills 的人当天就能跑。
r/ClaudeAI 热帖回应 Anthropic「double-check 是反模式」:数完 config 里 125 条 must/never 后,社区共识是开一个无上下文的新 agent 做 review
官方建议在实践中要修正为:可以 review,但别让干活的 agent 自己 double-check。
Anthropic 官方降本长文说「double-check your work」类指令对新模型是反模式,模型本来就会做,再指令一遍等于让它重做已完成的工作。楼主照着清点自己的规则文件:66 处 must、54 处 never,合计 125 条,从没分过哪些是劝导哪些是硬约束。真正让帖子值钱的是评论区共识:用全新的、无上下文的 agent 拿工作产物做输入来审。高赞补充点破了本质:新 agent 意味着可以按需清空上下文,这是人类 reviewer 做不到的(人没法 flush 大脑记忆),新鲜上下文审查在 agent 时代反而比人际 code review 更彻底。这是「官方建议、社区消化、修正版实践」的完整样本,也是连续第三周「清理过度指令」话题的收官增量。
OpenAI 发布 GPT-6 Astra 官方 prompting 指南:删掉过度测试指令,让 Astra 自己审计你的 AGENTS.md
为旧模型加的防护栏正在拖慢新模型,官方的建议是定期删指令,甚至让 Astra 替你做这次审计。
OpenAI 开发者博客本周发文,把上周 danluu 实测的结论落成了官方操作指南。skill 描述要短而精准,过长会在 skill 变多时被截断,触发条件限定为「adding or changing a migration」这类具体动作,而不是泛泛的「working with databases」;AGENTS.md 要定期复查每条指令是否仍必要,别再要求每次编辑前读全部文档,Astra 自己能判断需要读什么;停止强制过度测试,旧模型需要被催着跑测试,Astra 会主动做,同样的指令现在只会导致 unnecessary testing。还有一条关于早停的判断:Astra 是他们 aligned 程度最高的模型,此前为防越权加的强限制语言反而会让它过早停下,应该在任务开始前定义完成标准,而不是要求首次实现后停下等审查。与 danluu 实测、r/ClaudeAI 的 125 条清点连起来看,指令减法已经是官方、社区、实测三方对齐的共识。
💬 社区热议
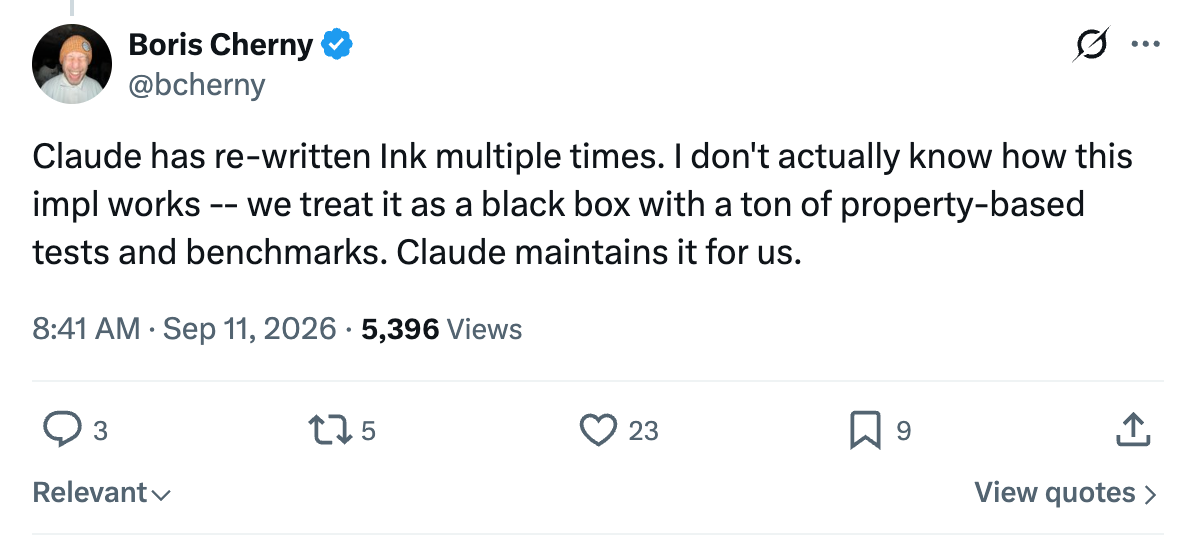
Claude Code 负责人:我维护的代码,我自己不读实现。 Boris Cherny 在 X 回复用户「AI 写的代码你要都读吗」时给了第一手答案:Claude Code 的终端渲染层 Ink 已经被 Claude 重写过多次,他不知道当前实现的具体原理,团队把它当黑盒,靠大量 property-based 测试和 benchmark 兜底,由 Claude 持续维护;他自己的规则是只在触碰关键代码时读 diff,代码不自己写。同一条推文串里他还区分了原型和生产代码:要扔掉的原型可以完全黑盒,生产代码另说。推文链接。这组回答给「看不懂 AI 代码怎么维护」提供了目前最高规格的实践样本:用测试边界替代逐行理解。
HN 给 v4.1 Flash 算账:cache 命中比传输同量数据还便宜,stateful API 会成为趋势。 DeepSeek v4.1 Flash 的发布帖在 HN 拿到 656 分 401 评,讨论最有价值的部分是成本账:用户 k9294 贴出同一任务 Astra $55.057 对 v4.1 Flash $0.615 的账单对比,其中 Astra 的 66% 开销在 cache;用户 mmastrac 报告 21 亿 token 花 $22.04、峰值约 400 tok/s。多条高赞判断指出,当 cache 命中价格低于网络传输成本,把状态放在服务端(stateful API)会成为默认架构,多轮长任务的选型逻辑从此改写。HN 讨论。
🧩 开源社区
alibaba/open-code-review
阿里内部 AI code review 助手开源,登顶本周 trending。 它解决通用 agent 做 code review 的三个老毛病:大改动漏文件、报的问题行号漂移、Skills 质量随 prompt 抖动。核心机制是确定性管线加 LLM Agent 的混合架构,行级精确评论,内置 NPE、线程安全、XSS、SQL 注入多语言规则集。官方基准基于 50 个开源仓库 200 个真实 PR 标注,同样底模下精准率和 F1 高于通用 agent,token 只花约九分之一,代价是召回率刻意放低换噪音减少。一条 npm 命令可装(@alibaba-group/open-code-review),Claude Code、Codex、Cursor、Kimi Code 都能接。
openai/plugins
Codex 官方插件样板间。 这个仓库收编了 OpenAI 官方维护的 Codex 插件示例,每个插件一个 .codex-plugin/plugin.json manifest,可组合 skills、MCP、hooks、agents 等伴生面。亮点示例包括 figma(Code to Canvas 与设计系统规则)、notion(规划与知识捕获)、build-ios-apps(SwiftUI 实现与调试循环)、expo、netlify 等。默认 marketplace 指向标准 plugins 目录,API key 登录用户有独立 marketplace。想给 Codex 写插件的人,从这里抄结构是最快路径。
multica-ai/multica
给 agent 派活,像给同事派活,本周连发两版。 开源的人机混合工作区:把 issue 派给 Claude Code、Codex 等 26 个 agent CLI 中的任一个,agent 自己领取任务、在你控制的 runtime 上执行、边做边评论、交回人工评审,意图、执行记录和 diff 始终挂在同一个 issue 上,没人需要重建上下文。本周 v0.4.43/44(9 月 11/15 日)落地 self-host 桌面端 dsh、钉钉/飞书原生回复与提及、issue 生命周期统一为四类状态。self-host 无锁定。
max-sixty/worktrunk
给并行 agent 用的 git worktree 管理器。 Claude Code 和 Codex 这类 agent 已经能无人值守跑长任务,同时开 5 到 10 个是常态,git 原生 worktree 给每个 agent 独立工作目录,但 UX 笨重到建一个 worktree 要把分支名打三遍。Worktrunk 用三条核心命令把 worktree 做到和分支一样顺手,按分支名寻址、路径按模板推导,支持 hooks 自动化本地流程。Rust 实现,年初发布后已成最主流的 worktree 管理器,cargo 可装。
✉️ 关于周报
「AGI 摸鱼周报」每周四发布(本来要摸鱼,结果又卷了一周 AI)。内容聚焦 coding agent 的产品更新、实操方法论与生态,帮你把一周值得读的东西压缩到十分钟。有建议或线索欢迎公众号后台留言。