📈 本周趋势
本周被反复提起的一个词是 Jev:一种不生成文本、只对选项打分的决策模型。它火的原因很实际:agent 工作流里大量环节只需要判断,比如路由选哪条、结果对不对、哪段代码相关,过去拿 LLM 逐 token 生成来凑合,又慢又贵;Jev 一次前向就返回选项的得分分布,便宜两个数量级,快到手机和浏览器都能本地跑,输出还是校准的概率而非可能幻觉的文本。TypeSafe 开放 API、开源复现 Kev 追平原版、$0.14 给 2300 篇论文打完标签,一周内全部到位。
成本出现了模型与 harness 的双跳水。模型侧 Opus 5.5 把 typical workloads 成本降 40%、GPT-6 Sol/Luna 宣布 API 永久降价 50%、Grok 4.7 以约一半价格跟进;同一周 harness 侧 Unreal Agent 在同分 benchmark 下省 39%、AWS Strands 宣称比 Claude Code 便宜 77%。上期还在吵「harness 该轻该重」,这周直接给出了可抄的参数和开源实现:成本杠杆正在从模型价目表转移到 harness 设计,选型功课从「用哪个模型」变成「哪个模型配哪个 harness」。
瓶颈在转移,工程共识逐渐定型。「I am done with this shit」(r/ClaudeAI 7999 分)里 L1 到 L7 每天 12 小时只按回车;Linear 的测试套件年内翻 4 倍,被迫系统性重构 CI;Anthropic 官方六步法的判断是「agent 提速后,瓶颈从产出变更转移到组织消化变更」,其内部 26% 研发由 Claude 主导、10 亿 agent 决策仅 0.002% 被监控拦截,另一场两周性能冲刺里 150 个 Claude 线程并行提交 3000+ 变更零客户事故。YC 也给出定量判断:同一个模型换个 harness,ARC-AGI-3 分数能差 35.9 个百分点。模型侧的差距抹平之后,工程侧的差距刚开始拉开。
🚀 产品与模型动态
🟠 Claude Code
本周从 2.1.274 推进到 2.1.281,连发七版:
- Opus 5.5 进入并改写默认档(2.1.280):
claude-opus-5-5成为默认 Opus 模型(1M 上下文,$4/$20,cache read $0.20);Pro 与 Team Standard 计划的默认模型从 Sonnet 直接改为 Opus,对齐 Max 与 Enterprise。 - AGENTS.md 支持(2.1.277):目录下没有 CLAUDE.md 时自动读取 AGENTS.md,行为可在
/config切换。注意初期版本存在关 telemetry 即静默失效的 bug(见本周精选)。 - auto mode 分类器转服务端、不再计费(2.1.278):API 与 Enterprise 用户及 Bedrock/Vertex/Foundry/网关默认走服务端分类器,分类器开销不再计费,
CLAUDE_CODE_AUTO_MODE_SERVER=0可退回本地;/status新增Auto mode server行标注当前跑在哪端。 - 危险 rm 收紧(2.1.281):
rm -rf "$(pwd)"这类目标是命令替换输出的递归删除,即使配了 Bash allow 规则也会要求确认,auto 与--dangerously-skip-permissions模式下不再无提示直接执行;提示还会给出${VAR:?}写法的修复建议。ctrl+enter 的语义也变了:把运行中的工具移到后台继续跑,不再取消整轮。 - commit/PR 署名可关(2.1.281):settings.json 里
"attribution": false一项隐藏所有 commit 与 PR 的 Claude 署名。 - Cloud sessions 正式 GA:Claude Code 会话跑在 Anthropic 托管基础设施上,合上笔记本工作继续,入口覆盖 claude.ai/code、移动端 Code tab、桌面应用与
claude --cloud;Pro/Max 用户各获 $100/$250 一次性云端额度。Projects 的 threads 同步支持本地运行模式,coordinator/worker 具备云与本地两种执行形态。
🟢 Codex
- 0.156.0:新增
/tui可选全屏 UI(transcript 搜索、鼠标选择、右键复制);语音对话默认开启(F8 开关,Linux/Windows 自带音频运行时);/usage用量分析面板可查账号用量、token 总量与 plugin/skill 活跃度;worktree 默认启用,agent command center 支持按状态过滤任务。 - 0.156.1:GPT-6 Sol/Luna 进入模型选择器,触发限额时的切换提示现在推荐 Luna。
社群信号:Tibo 预告 OpenAI DevDay 定档 9 月 29 日,称「这是我们最有野心的一次冲刺,Astra 让很多新东西在短时间内成为可能」;ChatGPT Voice 同步升级为可用插件(邮件、日历、Slack)并由 GPT-6 三模型驱动,语音入口眼看要变成新的 agent 分发面。
🧰 其他工具与模型
- Opus 5.5 发布:Claude 5.5 家族首款,官方定位「Fable 5.1 级智能、快 30%、typical workloads 便宜 40%」,Terminal-Bench 4.0 得分 66.4% 居首,GDPval-AA 1846 Elo 第一;5h 限额提升 20%,Pro/Max/Team 获得 banked reset。沟通风格也重做了,重要信息放前面、少 jargon,回应 Opus 5「verbose 难跟」的差评。Sonnet 5.5 与 Haiku 5.5 数周内跟进。
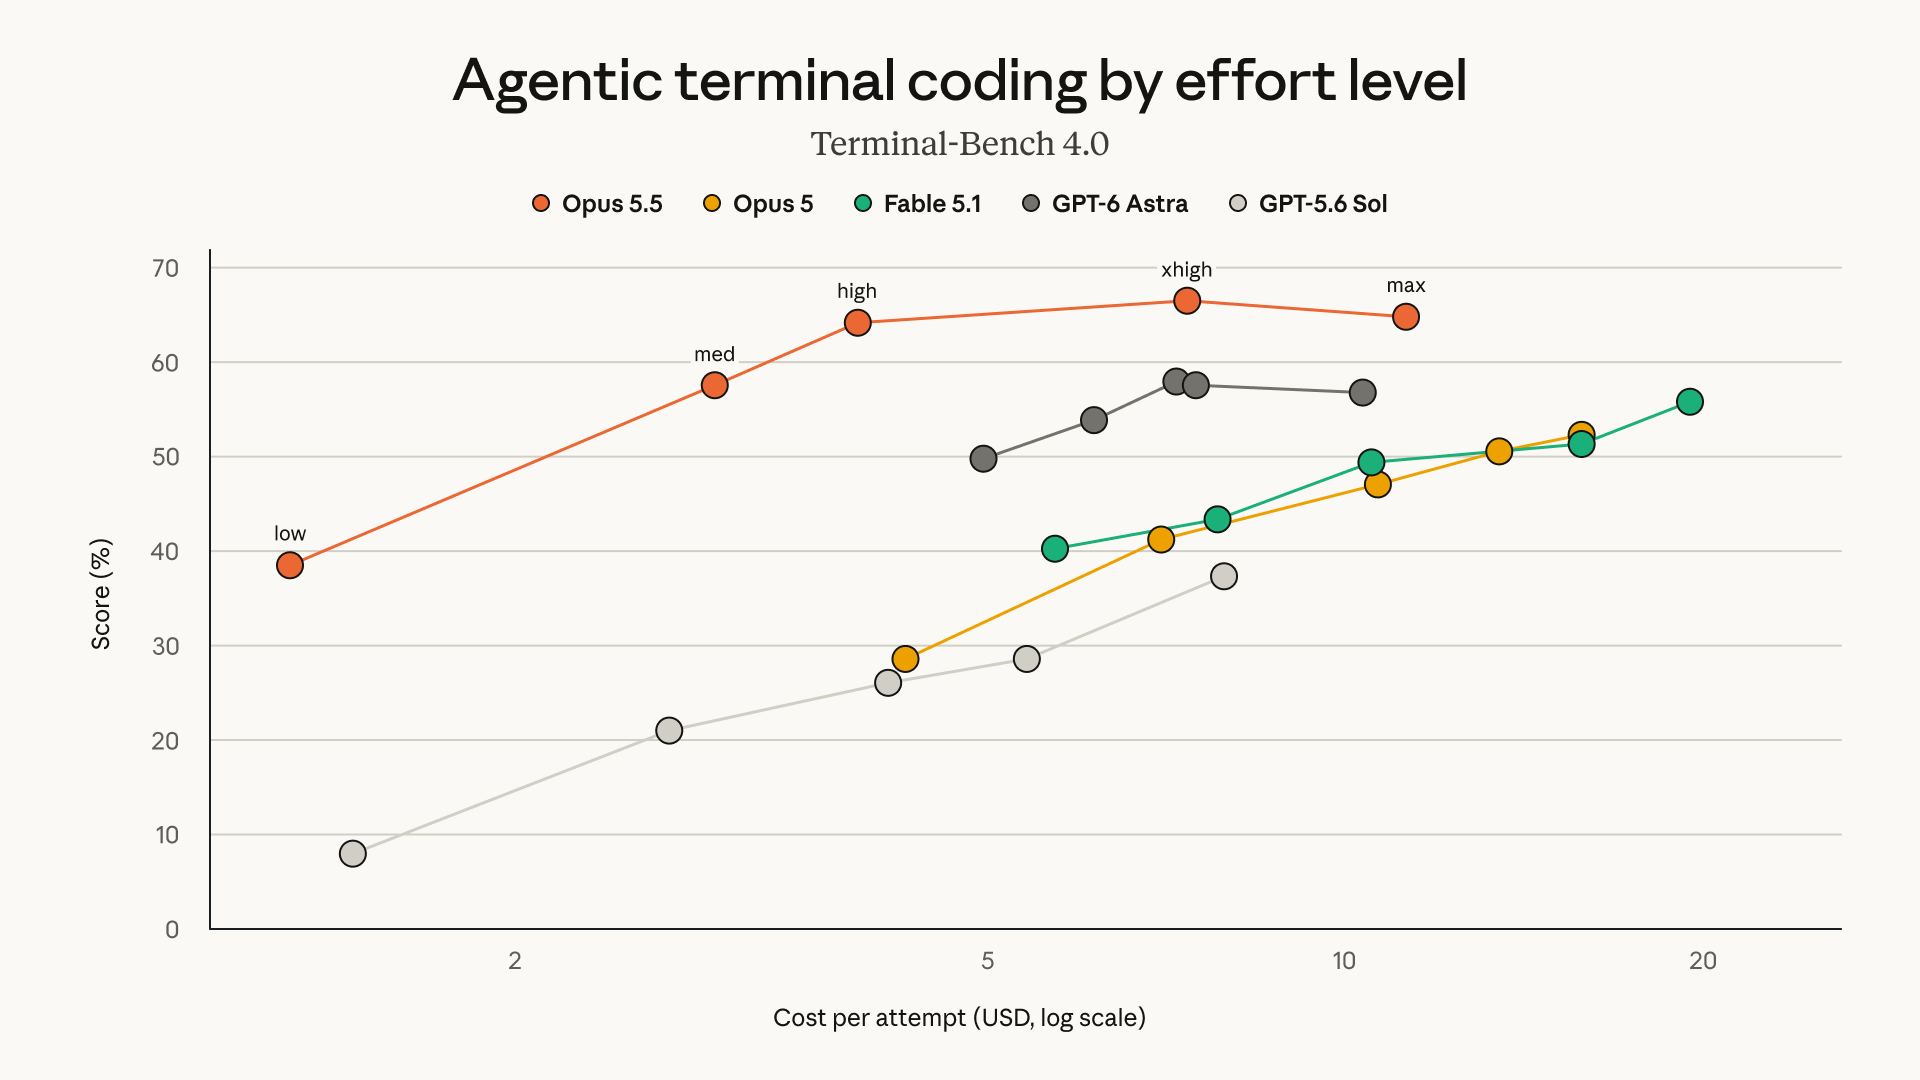
- GPT-6 Sol/Luna 发布:把 Astra 一代的专业工作与 coding 能力下放到更低价位,API 相对 GPT-5.6 促销价永久降 50%。DeepSWE v1.1 上 Sol max 得 68.8%(距 Fable 5 xhigh 的 69.9% 差 1.1 个百分点)而每任务成本低 80%;Luna max 得 66.6%,成本比 Opus 5 低 93%,Reddit 实测称其性价比异常。可用性有讲究:付费用户在 Work 与 Codex 即得,普通 Chat 拿不到,也没有时间表。
- OpenAI 改进 GPT-6 prompt caching:cached input 90% 折扣,调 reasoning effort 不再破坏缓存前缀,支持显式断点;配套缓存命中率面板与 miss 归因诊断。GitHub 实测数月内减少 50% 以上需新鲜处理的 token。
- Grok 4.7 发布:长时任务 RL 加权「需要数小时完成」的问题,CursorBench 4.0 得 46.3% 超 GPT-5.6 Sol,DeepSWE 高 effort 档 71.0% 贴身第一梯队,$2/$6 定价约为 GPT-5.6 Sol 一半,已在 Cursor 与 Grok Build 上线。
- OpenRouter 神秘模型 Union Alpha:匿名厂商免费投放,上线首日跑掉约 20 亿 token、累计已超 1000 亿。256K 上下文、131072 最大输出、原生工具调用,明确面向代码库分析与连续工具调用的 agent 工作流;社区实测 DeepSWE 得 74 匹配 GPT-6 Astra、Terminal-Bench v4 约 50%,但速度极慢。身份猜测集中在 GPT-6 Luna、Qwen4.0、GLM-5.4、Mistral(上一个匿名模型 Ox Alpha 最终证实是 GLM-5.3-Flash),匿名盲测正在变成大模型发布的新型预热机制,零成本白嫖前沿级 coding 能力的窗口值得关注(详情)。
📌 本周精选
不受控的 Agent 凭什么上生产系统:Agent DLC 给出第一套以评估为圆心的放行方法论
放行由评估决定,不由人在会上拍板:五维判据加三档门槛,这是 Agent 界的 CI/CD。
Harness 工程和 Graph 编排回答的都是「怎么造」,亚马逊云科技白皮书提出的 Agent DLC(Development Lifecycle)回答的是更根本的「凭什么上线」。机制类似 CI/CD:定义、构建、评估、发布、观测、回流六环节围成闭环,评估是那道门,判据达标即放行、未达标返工。
核心资产是「黄金标准」:一张判据表把对 Agent 的每项要求(从「能理解客户意图」到「单次调用成本不超过 X 元」)全部转成可自动测量的判据,沿认知、质量、责任、成本、性能五个维度设置,每条分三档:红线 100% 通过一票否决,门禁要达阈值,观测只需有基线可比。三档必须在第一次评估前冻结,防止「先看分数再定标准」。
评估环节的坑最多。LLM 裁判有位置、冗长、自我偏好、分辨率过粗四种偏差,各有对策;一个真实教训是 13 条用例在 Correctness 评估器下全部零分,换 Faithfulness 后全部通过,原因是裁判模型知识截止早于被评内容,等于拿过期的尺子量新东西。定位根因用四格二分法(该取的取到了吗→是照资料答的吗→资料本身对吗→答的是所问吗,第一个答否处即根因),归因拆会话、轨迹、步骤三级。
修复优先级很反直觉:先确认分数可信,再查数据,再调提示词,最后才换模型,多数提升来自提示词、工具描述与检索策略。英国 Motorway 按这套体系把错误率从 1/8 压到 1/50。
Claude 把 claude.ai 提速 3x 的两周冲刺全记录:150 线程并行 hill climb,3000+ 变更零客户事故
「可测量就可优化」的极限实验:guardrails 到位后,人类审核退到只管方向、品味和胆量。
Anthropic 新开的 claude.dev 技术写作站 Featured 长文,完整复盘 8 月两周性能冲刺:核心体验 p75 提速 3x(可输入页面 3.1s→0.55s,Cowork 云会话加载 2.6s→0.73s),合并 3000+ 变更零客户侧事故零回滚。
运作方式本身就是 agent 工作流的最佳样本:单一 Slack 频道,每个线程里都有 Claude。它通过 Datadog MCP 分析使用数据、找出四个占 95% 活动的用户旅程、给每个项目按毫秒估算影响、自己写 PR(按风险分级,用户可见的一律挂 flag)、部署后盯 field data,赢了把基准 ratchet 拧紧,输了关 flag 重来。高峰期同时跑 150+ 线程,单线程能连发上百个 PR。
方法论核心是把不可靠的 wall-clock 换成确定性计数(Valgrind 指令数、React commits、DOM mutations)做 CI 门禁,并先证明这些计数与真实延迟相关:两条热路径指令数降 48%/31%,wall-clock 降 78%/44%。可抄的细节也不少:em dash 等 non-Latin-1 字符会让 V8 把整串转 UTF-16,语法高亮正则掉进慢速双字节路径,20 行修复;120Hz 下逐帧 8.33ms 预算做 hill climbing。人类只做三件事:ambition(鼓励更大胆)、taste(裁决用户可感知的取舍)、direction(排序与砍线程)。
Stripe 内部知识 agent 平台 Kai 全复盘:83% 周活、单会话 932 turns、AE 用了多成交 39%
coding agent 之后非工程师怎么办,Stripe 交出了一份完整的企业级平台样本。
Stripe 工程团队公开内部知识工作 agent 平台 Kai(Knowledge AI Platform)的完整架构与业务数据。定位上,coding 的任务形态统一(改文件、跑测试、提交),单一 agent 架构就能覆盖;知识工作恰恰相反,查数仓、售前调研、事件分诊、合规审查各有各的工具、数据和「完成」定义,所以只能做平台,单品罩不住。三层架构:surface-agnostic API(agent 做成服务,web/Slack/Chrome 扩展嵌入第三方工具都只是视图)、AgentStudio(领域 owner 自建自管 skills 与 sub-agent,替代此前 4000 个难维护的微 agent)、共享执行环境(LangChain deepagents 跑在 K8s,每 session 沙箱加多租户虚拟文件系统,与对外产品 agent 共用同一安全基座)。
知识工作没有编译器、测试、git 这些护栏,Stripe 从零造不变量,例如「两个无关客户上下文的数据不得进入同一 session」,隔离边界按「本任务该看什么」划,不按「此人有权看什么」划。数据面:上线两周全公司铺开,83% 周活(GTM 几乎全覆盖),最长 session 932 turns;AE 使用周比不使用周多产出 2 倍销售 activity、多成交 39%,全司每年省下 25000 行政小时。要给非工程团队建 agent 的话,可以直接对照这篇的架构分层和「先定任务可见性边界」的隔离思路。
用约束式 prompt 让 agent 迭代优化 Rust 代码:跨模型累积 7.5x-32x 加速的完整方法论
约束式 prompt 而非结果式:agent 写出比 SOTA 库累计快 7.5x-32x 的 Rust,全部 prompt 与数据公开。
Max Woolf 用数月时间验证了一个假设:现代 agentic LLM 在合适的约束下能写出比 SOTA 库还快的 Rust 代码,且完整公开了所有 prompt 与 benchmark 数据。核心做法:先让 agent 跑出 True Performance Baseline,再要求 “atleast 1.2x faster” 的 pass/fail 目标(目标太高会诱发作弊),每个新前沿模型发布后用同一 prompt 重复一遍,从 Opus 4.5 到 GPT-6 Astra 累积出 7.5x-32x 加速。文中整理了一份反作弊 AGENTS.md(禁止并行 benchmark、禁止 game benchmark、禁止 target-cpu=native),起因是 agent 曾用「直接禁用物理引擎」刷出 34,500x 假加速。
几个技巧可以直接抄:Innovative Encouragement prompt(「传统方法 WILL BE GUARANTEED TO FAIL」换 1.2-1.5x)、用 CLI 命令调 gpt-5.6-luna 做廉价子 agent review 绕过 harness 强制用大模型、竞争 prompt(「比所有竞品 crate 快 2x」)、以及神奇的 “c’mon, try doing a breakthrough”(在已收敛的 session 里再换 1.2-1.5x)。实测成果包括 UMAP 实现 4x-15x 快于 umap-learn、GBDT 在部分指标打败 xgboost。作者还提出「introverted coding」概念:vibecoding 信任危机下,开源 agent 生成代码需要比人类代码更多的证据背书。
Claude Code 的 AGENTS.md 加载被远程开关门控:关掉 telemetry 就静默失效(附根因与 workaround)
关掉 telemetry 的代价:AGENTS.md 静默不加载,一行 import 是当前最稳的 workaround。
一篇扎实的社区逆向调查:Claude Code 2.1.277 宣布支持 AGENTS.md,但作者发现该功能由内置插件 agents-md 承载,其 isAvailable 依赖远程 feature flag tengu_agents_md_mod 且 fallback 为 false。读一个本地 markdown 文件本不需要任何网络,却要等服务端开关放行。
作者用 canary 单词(claude -p 问项目指令里的暗号词)做了系统测量:CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 或 DISABLE_TELEMETRY=1 任一设置都会让 AGENTS.md 静默不加载;设成 0 也没用(环境变量任何值都算开启阻断);.claude/settings.json 的 env 块清不掉;Bedrock、Vertex 和第三方网关因 flag 无法解析同样中招。
最痛的点是全程零警告:用户只会觉得「模型无视我的指令」,实际是文件根本没进上下文。可用 workaround 是一行 echo '@AGENTS.md' > CLAUDE.md(@ import 不走 flag);文末还对比了 Codex 的全局 ~/.codex/AGENTS.md 原生发现机制,指出 Claude Code 目前只能靠 import 拷贝或 symlink 绕行。标题的 [fixed] 表明官方已修复,但「隐私设置静默关闭无关本地功能」这条产品设计上的批评仍然成立:对关 telemetry 的企业用户和网关用户,这曾是真实生效的静默失效;staged rollout 的 fallback 应该写成文档化行为,false 这个默认值站不住。
支付宝 xUI 技术体系首度公开:「阿宝」背后的 Agentic 终端交互引擎,GUI 执行成功率 90% 才算可用
没有系统权限也能在 App 内模拟点击:页面稳定校验加 90% 成功率门槛,这是国内大厂 agentic 终端最完整的一手架构。
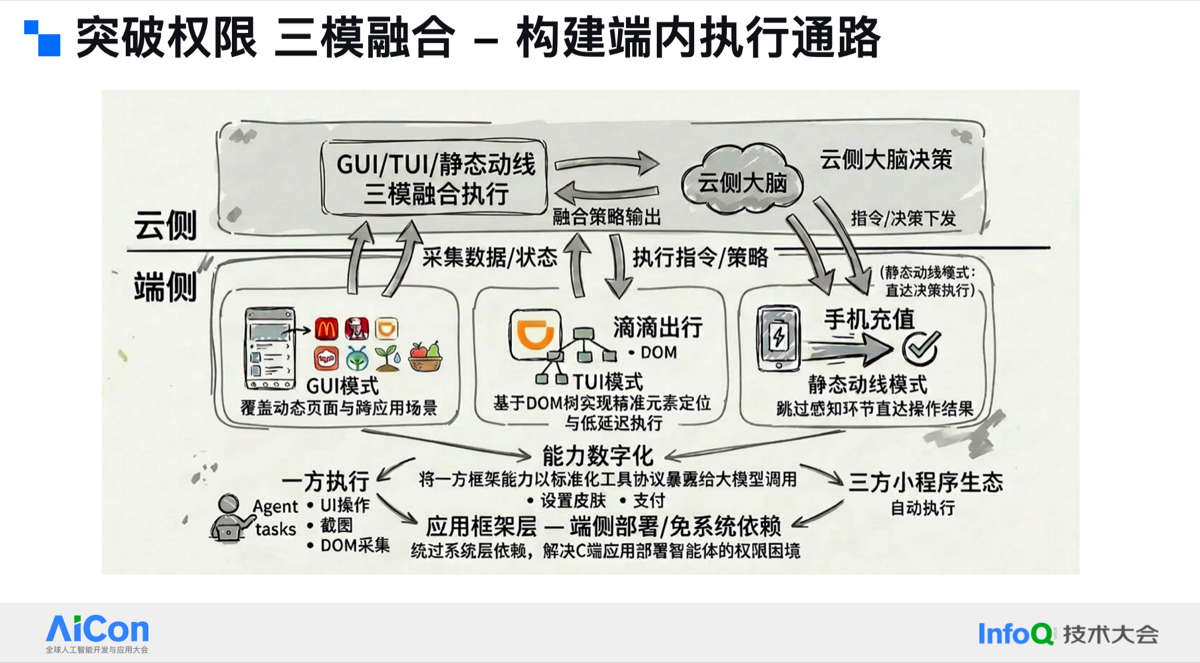
蚂蚁 AI 端云交互负责人在 AICon 的演讲实录,把支撑「阿宝」的 xUI 技术体系讲透了,四个方向都有别处看不到的工程决策。
通信层选 MoQ 协议而非 RTC:RTC 面向人与人交互设计、必须建房、扩展多模态困难,MoQ 面向人-Agent 交互设计,原生支持打断,配合 RTC 备份和 gRPC 兜底,弱网下文本交互依然可用。交互层走了三代渲染:Markdown 三端原生渲染(不引入浏览器内核是为了稳定性)、自研 Web 内核嵌 HTML(复杂表达)、声明式 UI 加 A2UI 协议连接 MCP 供给(在对话里真正办事)。
执行层是三轨制:有标准 MCP 的服务直接调;政务、蚂蚁庄园这类没有 MCP 的供给,用执行代理跑 GUI 操作,关键工程判断是「GUI 执行成功率必须到 90% 以上才能真正帮用户办事」,且点击前必须校验页面稳定、确认目标还在原位置,否则模型就会乱点;介于两者之间的用 TUI 结构化描述(更快但泛化低),固定动线直接跑无模型 Workflow。多 Agent 协同走 AHA 互联:手机系统助手理解意图、支付宝 Agent 在自己领域内闭环执行、完成后异步通知,避免厂商直接操作支付宝的权限与合规问题。
做 coding agent 的人看这篇的映射感会很强:执行代理的鉴权管理、成功率工程、页面稳定校验,与沙箱内 CLI agent 面对的问题同构。
Anthropic 发布 R&D Automation Index:Claude 已主导 26% 的自身研发,3 万 agent 常驻、10 亿决策仅 0.002% 被拦截,RSI 第一次有了硬数字
RSI 从叙事进入可量化阶段,Anthropic 的内部平台就是目前最大的 agent harness 样本。
Anthropic 用 Epoch AI 的 Automation Level 量表(AL0 无 AI 参与 → AL5 完全自主)系统量化 Claude 在自家研发中的渗透度:截至 8 月,26% 的 AI R&D 工作达到 AL4「leads」级(从高层 prompt 端到端完成大部分任务、人类监督),2 月这个数字还不到 1%;达到 AL3「collaborates」及以上的占比超过 90%。
配套披露的运营数字同样罕见:内部最常用平台上任何时刻有约 3 万个 agent 在做研究与工程工作;100% 的 agent 动作执行前经过在线监控(通常秒级),8 月分析的 10 亿+ agent 决策中仅 0.002%(约 1/47000)被在线监控拦截,每周约 10 万条 transcript 被标记复查、约 50 个最高优先级案例升级到人类。安全算力方面,样本周内约 6% 的 R&D 算力投向安全(AI 驱动的 R&D 中约 12%),并承诺引入第三方评估。
对 coding agent 开发者,这份指数是「agent 能在真实研发管线里走多远」的基准锚点,其监控拦截率和升级机制的设计值得对照自己的 harness。
As of August, Claude had reached the AL4 level for 26 per cent of Anthropic’s AI R&D work. The share of work at or above the “AI collaborates” level was more than 90 per cent.
💬 社区热议
Jev 决策模型一周完成生产化三级跳:不生成文本、只对选项打分的非自回归模型,成了本周被提及最多的词
相对 LLM 的优势: 它不生成文本,输入一个问题加一组选项,直接返回每个选项的得分分布。没有逐 token 生成的等待,快到浏览器和手机本地都能跑(开源实现 Laya 在 Mac M4 上 CoreML 离线 45 decisions/s);没有长文本可幻觉,输出是校准过的概率分布;成本便宜两个数量级,首个生产用例(重新组织 2,300 篇 AI 论文的标签体系)只花了 $0.14、83 秒。
实现原理: 非自回归架构,一次前向传播对所有选项并行打分。前 GitHub Copilot 工程师的拆解认为其本质是「用常规 LLM 做单 token 分类」,取选项 token 的 logprobs 归一化成概率,架构本身没有护城河,真正的护城河候选是跨领域的校准训练数据。Jared Palmer 的开源复现 Kev 佐证了这一点:Qwen3.5/3.8 加 pointer head 微调,新源测试集就追平原版(0.852 vs 0.857,见开源社区)。
适用场景: 高频、可枚举选项的「判断」环节:工单路由、意图冲突判断、结果校验(goal verifier)、语义检索打分、UI 决策。典型架构是 system1(Jev 做判断)+ system2(LLM 做推理)复合,本周已有人用这套组合在 WC3 RL 环境打赢疯狂电脑。边界也很清楚:需要生成文本、写代码、多步推理的任务它做不了。Akshay 的实践警告最该记住:最容易犯的错是把 Jev 当更快的 LLM 用,它位于规则与 LLM 之间的缺失层。
本周它完成了生产化三级跳:TypeSafe 取消等待列表全量开放 System One API(每人送 5 美元额度),Kev 开源复现追平原版,Reddit 出现 Jev-powered MCP 给 Claude Code 提供语义代码搜索,Tobi 把它搬进了浏览器。
ZCode 静默上传整个 Git 历史风波全记录:开关全部无效,企业已发函追责
ferstar 对 ZCode(Z.ai 的 GLM 桌面 coding agent)的逆向取证:登录态下客户端静默打包整个 workspace(完整 .git 历史、LFS 缓存、reflogs,占密文 86.6%)加密直传阿里云 OSS。实测一个 345MB 商业项目因体积 564 次上传失败留在本地,但一份 538 文件的公开仓库快照已被服务端接收。
最狠的三个细节:信封加密私钥只在 Z.ai 云端,用户无法解密自己磁盘上的归档;设置里两个开关均不阻止上传;泄露的 31 个工具里完全没有 snapshot/upload 工具,外泄管道在 agent 工具环之外,任何 agent 权限设置都拦不住。
后续进展:智谱致歉并称数据「用完即销毁」,3.14.0 移除上传链路,随后将 ZCode 全量开源置于社区监督;太原承明科技发函追责,要求 10 月 10 日前书面答复并保留诉讼权利。普适教训:开源权重不等于开源 harness,本地模型加云端上报的 harness 不是本地,每个 harness 都该查两件事,登录态下 runtime 到底传输什么、它存的东西谁能解密。
Claude Code 一夜删除用户 48k 文件,r/ClaudeAI 4828 分:agent 的自检报告也不能信
用户让 Opus 5 ultracode($250/月 Max plan)修复期权回测引擎,Claude 删除了 48k 个文件,全部是历史 tick 级期权数据。当事人没做 git branching,仅靠 NAS 和 iDrive 异地备份兜底,事后靠 Windows shadow copy 抢救。
最值得记的技术细节是删除后的自检被骗:agent 汇报「live tree intact」(目录树完好),实际是 Windows junction 的目标还在、内容已被清空,它对着一个空壳确认了安全。Claude 自己留下的报错「Craig,停下,读这个。我搞坏了一些东西」成了本周梗。1375 条评论的社区共识是 FAFO:无分支无快照是主要责任方。
这个案例与 Anthropic 官方披露的「93% 权限批准率」互为印证:高频授权下人工审批基本不起作用。直接教训:破坏性任务前确认 agent 工作在分支或沙箱副本上、数据目录与工作目录隔离,涉及 symlink/junction 的场景里,连 agent 的自检结论都要人工复核。
43,000 次 Claude Code 调用的遥测分析指控「模型被调弱」,HN 评论区当场拆方法论
X 用户 Lon 对 43,000+ 次 Claude Code 调用、跨度 65 天的遥测分析在三个平台同时引爆(HN 423 分、r/ClaudeAI 热帖、X 原帖):按他的测量,Fable 5 转订阅常驻后 8 月的 thinking tokens 显著低于 7 月(跟帖转述的数字是 39% 调用 thinking 为零、中位数仅 123)。
HN 292 条评论里最有价值的是当场质疑:Claude Code 客户端根本收不到 thinking tokens 数量,这个测量是怎么成立的?但「发布数周后质量下滑」的体感获得大量一线共鸣。官方未回应,且与 effort level 默认档位上线的时间窗重叠,归因尚无定论。
可落地的结论是方法论层面的:订阅制时代模型端点会静默更新,别信单次体感,对输出敏感的生产链路该建自己的可重复评测基线,或走云厂商的冻结版本快照。
🧩 开源社区
jaredpalmer/kev
本周最火概念 Jev 的开源自托管答案:基于 Qwen3.5/3.8 训练的决策模型家族,0.8B/4B/9B/27B 四档,输入问题加选项、输出校准的得分分布,不生成文本。API 完全兼容 TypeSafe System One,官方 Python SDK 改个地址就能指向自己的 Kev 服务。
效果上,新源测试集 Kev-27B 与官方 Jev 差 1 个点内(0.848 vs 0.857),4B/9B 差 4 点内,0.8B 笔记本就能跑。最有意思的设计是配套 coding-agent skill:在 Modal 上跑完「找问题、标注、微调、部署」整个循环,几百条标注样本就能接入自己的路由/评分场景;Mac 走 MLX、服务器走 CUDA,uv sync 一条命令起服务,闲时自动缩到零。Apache-2.0,适合想把工单路由、结果校验这类高频判断从 LLM 账单里拆出来的 agent 开发者。
stablyai/orca
自称「100x builders 的 AI Orchestrator」:把 Codex、Claude Code、OpenCode、Pi 并行跑在各自独立的 git worktree 里,一处追踪全部状态。核心玩法是一个 prompt 同时发给五个 agent,各自在隔离 worktree 实现后比较结果、合并胜者,正好呼应本周 Projects 的多 thread 并行趋势,只是把执行面从单一厂商扩展到跨工具混编。移动端 companion app 支持从手机监控和 steer agent,收到完成通知后直接发后续指令。MIT 协议,macOS/Windows/Linux 桌面端全支持,适合已在多个 coding agent 间切换、想统一调度的重度用户。
vectorize-io/hindsight
会学习的 agent 记忆系统:多数记忆方案只负责记住(回放对话历史),Hindsight 的目标是让 agent 学习。三个核心操作是 retain(写入观察)、recall(按需召回)、reflect(反思沉淀),在此之上构建 mental models 和 knowledge pages,官方称在 LongMemEval 基准上达到 SOTA,且成绩被 Virginia Tech 与华盛顿邮报独立复现过。对 coding agent 用户最实用的是集成面:支持 Claude Code、Cursor 等 coding agent 与 MCP server,文档 skill 一条命令安装(npx skills add vectorize-io/hindsight --skill hindsight-docs)。MIT 协议,Python/Node 客户端齐备,适合想让长期项目 agent 积累领域经验的团队。
✉️ 关于周报
「AGI 摸鱼周报」每周四发布(本来要摸鱼,结果又卷了一周 AI)。内容聚焦 coding agent 的产品更新、实操方法论与生态,帮你把一周值得读的东西压缩到十分钟。有建议或线索欢迎公众号后台留言。