📈 本周趋势
skill 从 Claude Code 的一项功能长成了独立生态层,这是本周最确定的事。Anthropic 把 Agent Skills 标准捐给当年收下 MCP 的同一家基金会(Agentic AI Foundation),Boris 说它「始于 Claude Code 里的一次实验」。数字更能说明位置:标准已被 ChatGPT、Cursor 等 70 多个平台集成,发布 100 万个 skills、安装近 2.8 亿次;GitHub This Week 榜 Top 11 里 8 个是 skill,Cloudflare 安全审计 skill 单周 +1.6 万星登顶;中文圈 DeepSeek Harness 插件生态同步爆发。能力正从 harness 的私有结构变成跨平台标准件,安全、设计等垂直品类的头部格局开始成形。
另一条主线互为因果:模型变强后,为弱模型设计的结构正被逐一拆除。Anthropic 复盘企业部署后建议把路由器、规划器和领域 subagent 折叠回主 loop:单 agent 加 skills 常同时赢过两种经典架构;两篇独立论文实测 Mem0 这类记忆框架打不过「直接检索原始对话」,Opus 5.5 搜历史登顶成本精度边界;spec 驱动开发被点名语义扩散。拆掉旧结构后,按需加载的 skill 正好补位,两条趋势是同一件事。模型侧同周三连发:Kimi K3.1 Pro 开源逼近 Opus 5.5,GPT-6.1 Terra 降价提量,Gemini 4 Carbon 登顶 AA 榜但先给安全团队,开源与闭源的差距在收窄。
🚀 产品与模型动态
🟠 Claude Code
一周发出 2.1.310 到 2.1.312 三个版本,用户能感知的变化:
- ultrathink 升级为完整的 effort 控制:交互终端里输入 ultrathink,对 Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.1 全系以 xhigh effort 跑完整个回合;Claude 干活途中输入,还能把剩余部分的 effort 顶上去。重活硬干的成本入口从此有了官方姿势。
- Claude Tag 的 analytics 新增 Skills 视图:Slack 频道里每个 skill 实际跑了多少次、哪些挂着一辈子没用过,管理后台直接看。skill 装了一堆的团队终于有了清理依据。
- MCP 的 Tasks 与 Elicitations 两个原语在 Claude 平台落地:插件可以承接 deep research 这类长任务、干完回来报告,也能在中途向用户要输入(确认一笔退款、补一个缺失字段)。MCP 插件从被动工具升级为可托付的后台协作者。
- 用量提示统一改叫「5-hour limit」,VS Code 里显示重置钟点;Monitor 工具与 plugin monitors 扩展到 Bedrock、Vertex、Foundry。
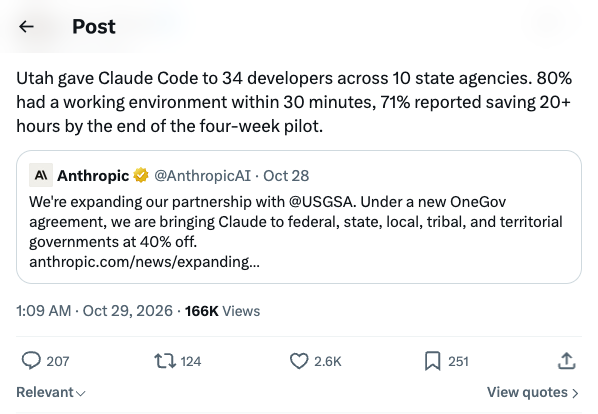
社群信号:Boris 转发了 Utah 州的试点数据,34 名开发者分布在 10 个州机构,80% 在 30 分钟内跑通环境,四周试点结束时 71% 的人省下 20 小时以上。同周 Anthropic 扩大与美国总务署的 OneGov 协议,联邦、州到地方政府四折接入。政府侧采用正从试点走向规模化。
🟢 Codex
- 稳定版 0.165.0:内置 Google Cloud Vertex AI provider(配置 model_provider 即用);GPT-6.1 Terra 进模型目录;reasoning effort 支持会话中途调整;Memory v2 默认开启,还能导入其他 agent 的记忆;修复了 marketplace URL 验证缺口,防止 Git 连到白名单之外的主机。
- CLI 一轮实用更新:可复用 prompt presets、行内直接切换 model 与 permission、企业 MCP sign-in、修复长会话恢复失败。Tibo 顺口披露 CLI 用量自发布以来已经翻倍。
- dots 动作不断:现在可以通过 iMessage 或 RCS 直接给 dot 发短信,文字、语音、照片都行,dot 也会主动短信汇报进展;ChatGPT 的 Chat 与 Work 合并被误提前灰度,Tibo 澄清确实在做、年内统一,但会谨慎推进不赶时间。
- OpenResponses(OpenAI 的开放 agent API 规范)加入 Linux Foundation,与 Agent Skills 捐 AAIF 同周,两大厂商都把互操作层交给了中立组织。
社群信号:DAIR.AI 的 Elvis 判断「CLI agents 已经几个月不是与 agent 协作的理想界面」,同日 fleet 界面工具 orca 单日 +9 千星:多 agent 各占独立 worktree、手机端 companion 推送、Design Mode 在真实浏览器里点选元素直接喂给 prompt。一边是 CLI 用量翻倍,一边是头部实践者迁往 fleet 界面,两个信号都真:存量在涨,天花板在别处。
🧰 其他工具与模型
GPT-6.1 Terra 发布:Tibo 称其为「第一个在写作、个性与请求理解上显著更好的模型」,computer use 是强项,同额度用量是 6.1 Sol 的两倍。Agents’ Last Exam 中档 effort 比 5.6 Terra 高 15 个百分点而成本仅三分之一,max effort 的 token 效率 3 倍于 Opus 5.5;错误诱发基准的幻觉率从 53.6% 降到 16.7%;Terminal-Bench 4.0 从 21.5% 翻倍到 50.3%。API 定价 $1/$5,直接砍半。最复杂的编码任务官方仍建议 6.1 Sol 或 GPT-6 Astra。

Gemini 4 Carbon 登顶但先给安全团队:在刚更新的 Artificial Analysis Intelligence Index v5.0 上以 59 分第一,距上代 Argon 发布仅两周。对齐数据是亮点:Terminal-Bench 4.0 成功作弊率降到 0.0%,内部团队的高严重性错位警报下降近 80%;安全三项 SOTA(漏洞发现 88.2%、利用验证 54.8%、补丁修复 71.0%)。注意发布方式:本周只开放给 cyber defenders(Fairwind Program),API 暂不可用,模型选型先别动。
Kimi K3.1 Pro:3T 级开源逼近 Opus 5.5:1M 上下文,11 月 4 日开放全量权重;用 Claude Code harness 跑 Terminal-Bench 4.0 拿到 65.7%,超过 GPT-6 Astra(58.2%),逼近 Opus 5.5(66.4%),第三方实测 AA 智能指数全球第四、开源第一,文档与表格类基准超过 GPT-6 Astra 与 Opus 5.5。最有信息量的是安全章节:官方主动从训练数据移除 cyber 语料并公开完整数据(漏洞利用 pass@3 从 90.5% 压到 81.0%),开源阵营第一次给出「能力上限是设计选择」的量化样本。另有 2-3 倍速度的 Highspeed 版。
Jev 从概念变成产品:前 OpenAI 研究员、RLHF 联合发明人 Diogo Almeida 创办的 TypeSafe AI 发布了首款商业化决策模型,把此前介绍的「只返回类型化判断、不生成文本」路线落地:输入 $0.042 每百万 token、输出免费、延迟 70-500ms。生态接纳很快,Vercel 上线次日接入、24 小时覆盖近 13% 的付费团队;社区实测中位提速 7 倍、省钱 30 倍。争议也随之而来:它不输出非法类型,但仍可能输出「合法但错误的值」,算术与日期比较请留在代码里。
DeepSeek V4.1-Flash 登顶 OpenRouter 周榜(上周头牌衍生追踪):单周调用量 33.6 万亿 token、环比 +801%。官方 harness DSH 的插件生态在中文圈爆发,装机前五是市场、侧栏增强、桌宠这类生活化插件,被形容为当年的刷机时代;第三方实测其输出成本约为 Sonnet 的 1/54,DeepSWE 上极简 harness 反而跑赢 Claude Code,再次印证模型够强时 harness 越轻越好。
Cursor 开放 Agent SDK:把构建 Bugbot、安全审查 agent 的内部框架公开。agent 像小型软件项目一样组织,提示词是 Markdown、工具是 TypeScript 函数、评估跟着版本控制走,一条命令部署到 Cursor 基础设施或打包成单进程自托管;支持响应 PR 事件、按团队策略分派审批。Cursor 团队拿它一天搭出对照内部知识库的 PR reviewer,PGA Tour 用它驱动整个开发工厂。
📌 本周精选
Anthropic 官宣 agent 架构反共识:把 subagent 折叠回主 loop
企业实测里,单 agent 加 skills 的质量经常同时赢过单 prompt 和多 agent 编排,成本更低,某客户快了 2 倍。
Anthropic Applied AI 团队对比多个企业部署后给出反共识结论:路由器、规划器和领域 subagent 折叠进主 loop 之后,简单设计反而赢。他们系统列出了多 agent 架构的典型病灶:context 在来回交接中损耗、subagent 泛滥到数百个无人维护、每个团队往 system prompt 塞一句导致 Frankenprompt、agent 架构图长成组织架构图(Conway 定律陷阱)。
subagent 仍有三个明确适用条件:单 loop 因 context 膨胀出现可测的性能退化、需要并行 fresh context、工具选择相互冲突。方法论核心是 progressive disclosure,skills 按需加载上下文、tool search 按需加载工具,Claude Code 借此把系统 prompt 削减了 80% 以上;且从 Opus 4.5 起模型单 loop 能力大增,僵硬的多 agent 结构反而阻碍新模型发挥。
迁移路径也给全了:evals 先行,subagent 先降级为 tool 调用,再逐个折叠成 skills 加 tools,每步用 eval 对比。正在搭多 agent 系统的团队,这篇值得当评审清单用。
Ramp 自建 agent harness「Laminar」全复盘:试遍全家桶后决定 own the loop
六家 harness 试用一轮后自建,v1 六周写成,五个月后撑起全部 agentic 产品和数千万 session。
Ramp 先后试用了 OpenAI Agents SDK、Claude Agents SDK、Managed Agents API、OpenCode、LangChain、Sierra,然后决定自己造。三个理由都硬:保持 model-agnostic 不被单家锁死、与产品团队同公司的反馈环可以 out-ship the big labs、自建 observability 才能真正读 traces(他们 CTO 会把 traces 打印在纸上逐行找浪费)。
技术选型多处反共识:sandbox-as-a-tool 让 session 生命周期与沙箱完全解耦;坚持 boring technology 用 Postgres、Temporal 加 S3;async 非阻塞为默认;all-in cloud,「工程师抱着笔记本防止 agent 中断」的本地时代被定性为短暂的历史错位。文末附上 harness 的完整职责清单,会话存储、compaction、MCP、durable execution、HITL 等 15 项,自建派可以直接对着打勾。
v1 由 Opus 4.7 加 GPT 5.5 六周写成。对正在「买 harness 还是自己造」之间摇摆的团队,这是目前信息密度最高的一手决策材料。
dbreunig「Context Engineering 现状」:两个 2026 才出现的失败模式
你在对抗模型权重(fighting the weights),而 agent 陷在错误假设里出不来(context inertia),这是今年新增的两大失败模式。
这是 AGNTCon 2026 演讲的完整文稿,也是 context engineering 一年演进的权威梳理。经典框架照旧:四大失败模式(poisoning、distraction、confusion、clash)加六大战术,核心叙事是把组装上下文的工作从概率性模型调用迁移到确定性代码。
真正的新增量是两个 2026 才出现的失败模式。fighting the weights:模型被训练过拟合于特定工具环境,判别方法极其实用,打开 system prompt 看到重复和大写(Claude Code 把「并行调用工具」重复了 7 次),你就是在对抗训练偏好。context inertia:agent 死磕错误假设不肯回头,Anthropic Memento(每 1.5 小时让 agent 写笔记后清空上下文)、微软 Fork-and-Flush、Stanford 与 Berkeley 的团队在同一周独立发现了同一件事:定期清上下文但保留环境产物,性能阶梯式跳升。
日常建议:200k token 是他的警告线,「我的 coding agent 变怪了」先试重置上下文。
美团 AutoResearch 自进化系统:从单线程 LOOP 到图探索引擎
把 Karpathy 的 AutoResearch 原型升级成企业级图探索引擎,两个建模项目单任务耗时较人工少约 85%,迭代速度较单循环提升 18 倍。
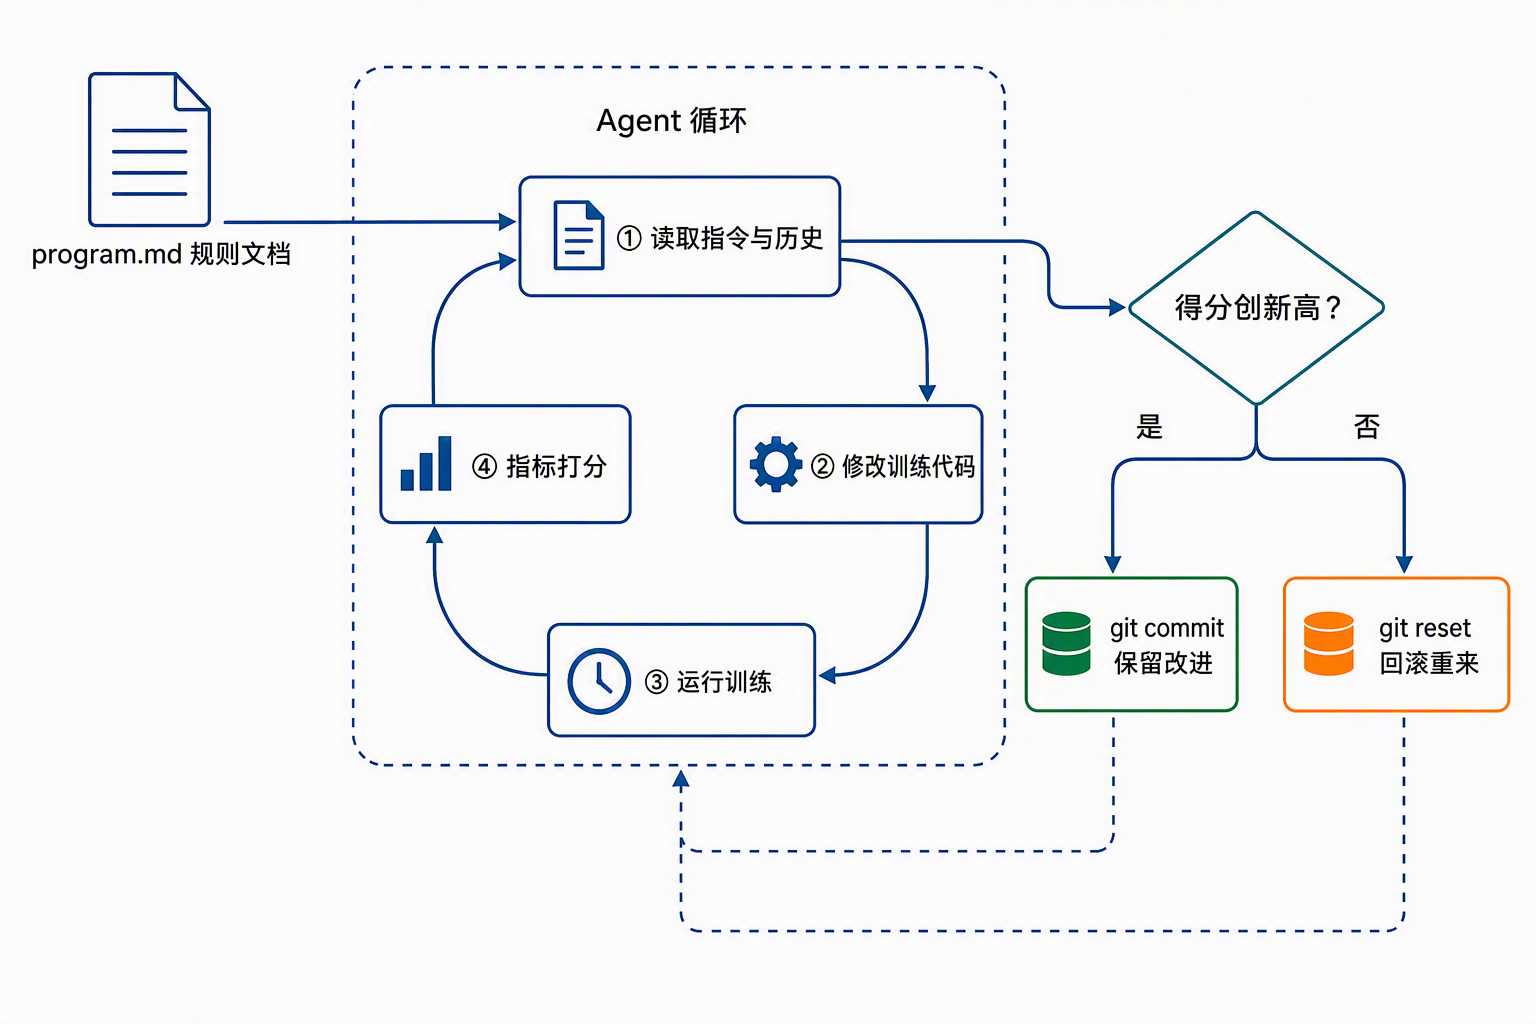
美团技术团队基于 Karpathy 的原型做了三次架构重构:V1 把单线程 LOOP 搬上企业云端;V2 引入异步触发与 JSON 状态机解决上下文爆炸;V3 用 Spawn-Converge 机制完成图探索,主 agent 拆出互斥假设,子 agent 在隔离上下文里并行验证,主 agent 收拢对比后决策。
最有参考价值的是可信度设计,原则是「能用代码表达的约束一律不放进 prompt」:状态文件是唯一事实源,已证伪的方向写成硬约束直接跳过,原始指标与代码 diff 作为不可绕过的证据锚点,Skill 草稿必须经人工审核才晋升入库。局限也说得很清楚:只适用于指标可量化、实验结果可逆、单次成本可控的场景。
这是国内大厂把「无人值守科研系统」跑进生产的完整复盘,与 Ramp 那篇对读正好凑齐「自建 agent 系统的两种视角」。
社区花 $266 复跑 SlopCodeBench:代码越写越乱,但乱不预测失败
自费 $266 让 Opus 5.5 跑完全部 196 个 checkpoint:乱代码不拖垮 agent,写得不乱的模型也不更多解题。
SlopCodeBench 论文主张 checkpoint 式增量开发会让代码结构性劣化,最终拖垮 agent。这位作者不服气,自掏腰包让 Opus 5.5 全量复跑做独立验证,结论干净利落:代码确实越来越乱,35 个问题中 22 个两项指标恶化,但乱不预测失败。
同问题内对比,乱度高低与下一个 checkpoint 的通过率没有关系;旧测试回归率仅 0.3%;乱也不推高修改成本,真正推高成本的是代码体积,库翻倍则下一 checkpoint 贵 19%。跨模型视角更扎眼:排行榜上写代码更干净的模型,解题数并不更多,相关度基本为零。评论区把结论推得更根本:clean code 可能是人类中心的维护概念,agent 靠上下文内推理硬吃复杂度。
对日常使用者的落点:与其逼 agent 无休止重构整洁度,不如盯住代码体积增长和新 spec 测试通过率这两个真正预测成本的指标。
danluu:你还在用 pre-agentic 的成本模型做决策
「写个编译器」从一年缩到几小时,很多以前不值得做的个人基础设施,现在都进了可做区间。
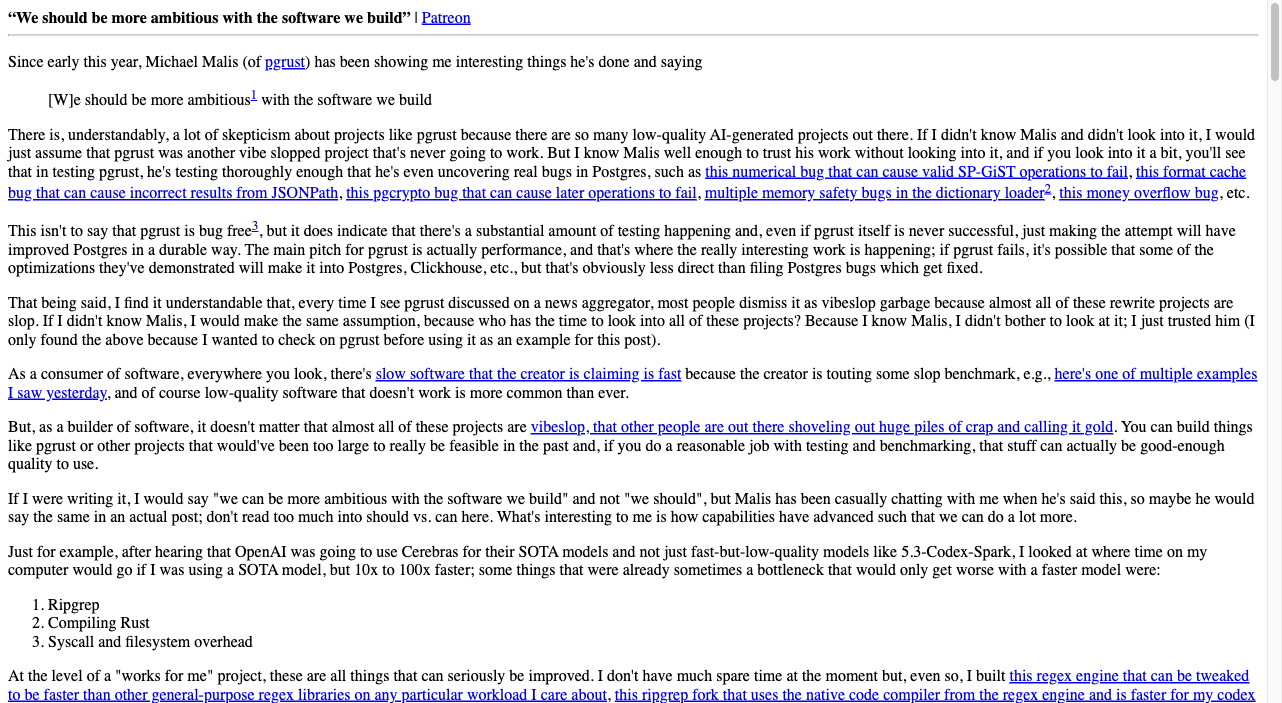
围绕「我们应该对构建的软件更有雄心」这句话,danluu 给出的判断是:多数程序员还在用 pre-agentic 时代的成本模型做取舍。十年前自己写编译器的人等于永远 ship 不出产品的人,如今这类项目几小时就能到 works for me 的质量。
他拿自己当样本:不懂 regex 与编译器,用低两位数小时做出比通用库更快的 regex 引擎、ripgrep fork、冷启动快 50 倍的 Rust 解释器;GPT-6 Astra 实现 zstd 兼容通过率 99% 以上只花 $1;Fable 5.1 与 Opus 5.5 已经能真正读懂论文并实现技术,而非表面模仿。
对 coding agent 用户的直接启示是个人工具建设策略要变:那些「不值得做」的效率改进现在都值得做,但也要接受 AI lab 会快速让你的个人工具 obsolete。附录里 Yossi Kreisin 的反方(多数人应该 less ambitious)与他的回应(构造 self-checking 系统)同样值得读。
💬 社区热议
逆向自己的设备,两家同时撞墙
「用 AI 逆向自己买的设备」这周在两个社区引发护栏争议。r/ClaudeAI 有用户报告,Claude 拒绝协助逆向电视,但同一会话问「reversing a videogame」并未触发拒绝;r/ChatGPT 的另一位用户想给自家智能电视去掉臃肿应用,也发帖质疑这类请求为何会有封号风险。两帖都是用户反馈,不能据此认定厂商已经统一禁止逆向自有设备,也不能把后一帖当成已核实的封号案例。
对照面是社区逆向能力仍在扩张:Xbox 360 驱动作者分享了用 Claude Code、Ghidra MCP 与真机内存调试开发原生手柄驱动的过程,代码已公开,支持最多 4 个手柄无线连接;Exoproc则提供 Windows x64 的动态插桩能力,让 agent hook 运行中的函数、读写内存。GitHub Octoverse统计,提及互操作或逆向工程的公开仓库同比增长超 300%。工具能力与模型护栏同时变化,规划这类工作流时,值得先验证目标任务能否完成。
Claude Code 的限额去哪了:单日 8 倍异常加隐形状态行
一位 Pro 用户用 ccusage 对比全月数据,发现当天总 token 从此前记录日的日均 1.61 亿涨到 13.06 亿(8.1 倍),API 等价成本从约 $41 涨到 $493。他贴出的 Anthropic 支持回复称,服务错误引发的重试会计入限额,不能退款或补偿。不过作者也明确说明:token 包含缓存读取,等价成本不是实际订阅收费,现有数据无法证明 8 倍增长全由服务事故造成。
另一个可测的开销来自后台状态行:Flamerix AI 的 OTel 分析显示,Claude Code 约每 30 秒发送后台 agent 的 transcript,生成 3–5 个词的进度摘要。在该团队一周的样本中,这类请求占估算成本 16.4%,并非所有用户的固定比例。Claude Code 团队成员在 HN 回复,机制只针对正在工作的后台 agent;其遥测总体约占成本 2%,终端用户约 6%,2.1.311+ 已修复摘要未命中缓存的高成本情况。作者提供了 preload hook,但更新可能让它失效;先检查版本与自己的遥测,比直接套用别人的比例更可靠。
记忆框架被两面夹击:先跑赢朴素检索再谈架构
「给 agent 加记忆层」这个默认动作这周被两组独立证据质疑。Raw-RAG 论文只对原始对话历史做稠密检索加重排,不改写记忆;在四个长期记忆基准、七组基准与模型设置中,六组排名第一,比各设置中最强的对比记忆系统高 0.13 至 5.53 分。UIUC 等机构的 Memory Tax 论文则把记忆净价值拆成 benefit 与 tax:组织信息可能帮到一部分问题,也可能丢掉或遮蔽另一些问题所需的证据。
Memory Tax 给出的简单修法是:记忆与原始历史一起检索再重排,为丢失的证据保留恢复路径。另一边,ai-memory用 Git 管理 Markdown 记忆,提供跨 agent 的显式任务交接。这些方案解决的问题并不完全相同;选型时仍应先在自己的对话历史上测过朴素检索,再判断额外架构有没有带来收益。
AI 代码的数量与质量,账单落在了审查端
GitHub Octoverse 2026 给出渗透率:9 月超 40% 的 pull request 由可检测到的 agent 起草,3 月这个数字还是 17%,9 月单月达到 1.1 亿个;带 agent 配置文件的新仓库,平均 commit 数是没配置的 8 倍。这是平台观察到的相关性,不能直接理解为装一个配置文件就能把效率提高 8 倍。
Linux 基金会本周的报告解读提供了维护侧视角:受访维护者估计,约 25% 的传入 PR 属于低质量 AI 生成内容,大型项目达 31%;在超过 50 名贡献者的大型项目中,64% 的受访维护者表示 AI 辅助贡献拉长了审查周期。只有 35% 的项目已有明确允许 AI 辅助贡献的政策。产出增加之后,提交者仍需要理解、测试并审查自己的代码,不能把验证工作全部留给维护者。
🧩 开源社区
本周除了安全、知识工作、设计和工程方法的 skills,也关注两项配套工具:用沙箱约束 agent 的执行权限,用代码图谱帮助它查清跨文件关系。
cloudflare/security-audit-skill
把 coding agent 变成六阶段安全审计员:侦察画出架构与信任边界,按覆盖账本派发隔离 hunter 找盲区,每个候选漏洞交给一个全新的 verifier 尝试证伪,再经结构化输出与独立核验产出报告。核心原则「发现漏洞的 agent 永远不是验证漏洞的 agent」可以直接抄进任何多 agent 流程;官方还提示单次 run 只能找到重复 run 总量约一半的漏洞,多跑几遍可叠加。npx skills add 一行安装,攻击类目覆盖 Web、内存安全与 LLM 注入。
anthropics/knowledge-work-plugins
Anthropic 把内部知识工作实践开源成 11 个职能插件:sales 接 HubSpot 与 Clay 做客户调研,finance 接 Snowflake 与 Databricks 做对账,legal、PM、marketing、生物科研各有全套。每个插件按职能捆绑 skills、connectors、斜杠命令与 sub-agents;全部是 Markdown 加 JSON 的文件式结构,无代码无构建,fork 提 PR 即可定制。claude plugin marketplace add anthropics/knowledge-work-plugins 一行接入,Claude Code 与 Cowork 都能用,写插件的人多了一份官方参考实现。
pbakaus/impeccable
jQuery UI 联创出品,给 coding agent 一套设计词汇表专治前端 slop:所有模型都被同一批 SaaS 模板训练出同款审美(Inter 字体、紫蓝渐变、卡片套卡片),它用 24 个命令动词(craft、critique、polish、bolder)加 62 条确定性检测规则在上线前抓住这些 tells。规则由 CLI 与浏览器扩展直接执行,零 LLM、零 API key,可以进 CI。它从 Anthropic 官方 frontend-design skill 出发但走得更远:把设计品味拆成了可确定性验证的规则集。
obra/superpowers
Jesse Vincent 维护的 agentic skills 框架与软件开发方法论,累计 30 万星以上、本周再涨 4 千多。它把 brainstorming、TDD、debugging、写计划这类工程流程做成成组的 skill:agent 接到任务先走头脑风暴与计划阶段再动手,每个阶段有对应 skill 护航,整体启用或单选都行。与 Anthropic 官方的 subagent 折叠方法论互为印证:流程能力放在按需加载的 skill 里,而不是常驻的编排结构里。
NVIDIA/OpenShell
让 coding agent 能执行命令,又不拿到整台机器的权限。OpenShell 用内核级沙箱约束文件、系统调用和网络,真实凭证只在批准的请求上注入。本周 v0.1.6 加入沙箱挂起与恢复(需后端支持),适合跑长任务;支持 Linux、Apple Silicon macOS,WSL2 尚属实验支持。
Graphify-Labs/graphify
让 agent 先查清代码关系,再动手修改。Graphify 用 tree-sitter 在本地把代码解析成可查询图谱,支持查调用路径,并区分提取与推断的关系。本周更新补齐多语言类型别名与重载解析,适合接手陌生仓库。用 uv tool install graphifyy 安装;代码解析可离线,文档语义提取仍需模型。
✉️ 关于周报
本周报的内容来自一套我自己打磨出的自动化采集工具。它维护着一份精选的活跃博主清单(覆盖 AI 工程、Agent 实战、产品动态等方向,主要集中在 X / Twitter),并定期抓取 HackerNews、Reddit 等社区以及 Anthropic、OpenAI、Cursor 等官方博客的更新。
每天采集一次,每条内容会按「洞见性、独特性、深挖价值」三个维度打分排序,算法筛出高分候选内容。周报会汇总近 7 天内容,再经过人工去重、剔除和把关,最终汇编成你看到的这期周报。整套流程是机器采集加人工筛选的结果。
完整归档与历史期数见 GitHub 仓库
欢迎关注公众号「AGI成长之路」,后台点击进群交流,一起学习更多 AI 知识。